Техничка
Как закрыть страницу от индексации: noindex, X-Robots-Tag и 410
Как убрать страницу из поиска Яндекса и Google: пошаговый алгоритм для уже проиндексированных URL, код noindex и X-Robots-Tag, таблица отличий от Disallow и 404.
Noindex — это указание поисковику не показывать страницу в выдаче. Коротко: robots.txt управляет обходом (что роботу можно скачивать), noindex убирает страницу из поиска, 404/410 — для страниц, которых больше нет, 301 — для переехавших. Инструменты не взаимозаменяемы: если применять их вперемешку, легко закрыть нужные страницы, оставить технические URL в выдаче или получить противоречивые сигналы.
В документации Google они разведены на уровне страницы, сервера и правил обхода: Robots meta tag, data-nosnippet, and X-Robots-Tag. Вывод практичный: сначала задача, потом инструмент.
Что такое noindex и как его поставить
Noindex оставляет страницу доступной пользователю, но убирает из поиска. В HTML это мета-тег в <head>:
<meta name="robots" content="noindex, follow">follow рядом означает: со страницы можно переходить по ссылкам, вес дальше передается. Обратная комбинация noindex, nofollow закрывает и показ, и переходы — нужна реже.
Для не-HTML файлов (PDF, выгрузки, изображения) тот же сигнал передается HTTP-заголовком X-Robots-Tag:
# nginx: закрыть все PDF раздела /docs/
location ~* ^/docs/.*\.pdf$ {
    add_header X-Robots-Tag "noindex";
}
# Apache (.htaccess)
<FilesMatch "\.(pdf)$">
Header set X-Robots-Tag "noindex"
</FilesMatch>Яндекс понимает и meta robots, и X-Robots-Tag. Директивы noindex в robots.txt не существует ни у Яндекса, ни у Google: закрыть индексацию строкой в robots.txt нельзя, только обход.
Типичные кандидаты на noindex: внутренний поиск по сайту, thank-you-страница после формы, служебные страницы фильтров, промежуточные сервисные URL, слабые дубли, которые пока не убраны архитектурно.
Чем Disallow отличается от noindex
robots.txt управляет обходом: что роботу можно скачивать. Это экономит краулинговый бюджет (лимит запросов робота к сайту) и хорошо для профилактики мусора:
User-agent: *
Disallow: /cart/
Disallow: /admin/
Disallow: /*?sort=
Но Disallow не удаляет URL из индекса: если адрес уже известен по ссылкам, страница остается в базе без сниппета, хотя владелец считает ее закрытой. Удаление из выдачи — это именно noindex.
Важный конфликт: если URL закрыт в robots.txt (робот не может скачать страницу) и одновременно имеет noindex в HTML — поисковик noindex не увидит. Порядок исправления: сначала снять Disallow, дождаться обхода с noindex, и только потом, при необходимости, снова ограничивать обход.
Как удалить страницу, которая уже в индексе
Пошаговый алгоритм:
- Проверьте, что страница действительно в выдаче: запрос
site:site.ru/page/или «Страницы в поиске» в Яндекс.Вебмастере и отчет «Индексирование → Страницы» в Search Console. - Уберите URL из Disallow в robots.txt, если он там был: робот должен увидеть noindex.
- Поставьте noindex на страницу (или X-Robots-Tag на файл).
- Запросите переобход: в Вебмастере — «Индексирование → Переобход страниц», в Search Console — «Проверка URL → Запросить индексирование».
- Дождитесь реакции: типично от нескольких дней до нескольких недель.
- Экстренно: в Search Console есть инструмент «Удаления» — временно прячет URL из выдачи примерно на полгода, пока основной сигнал дообрабатывается. В Яндексе аналогично работает «Удалить страницу» в Вебмастере.
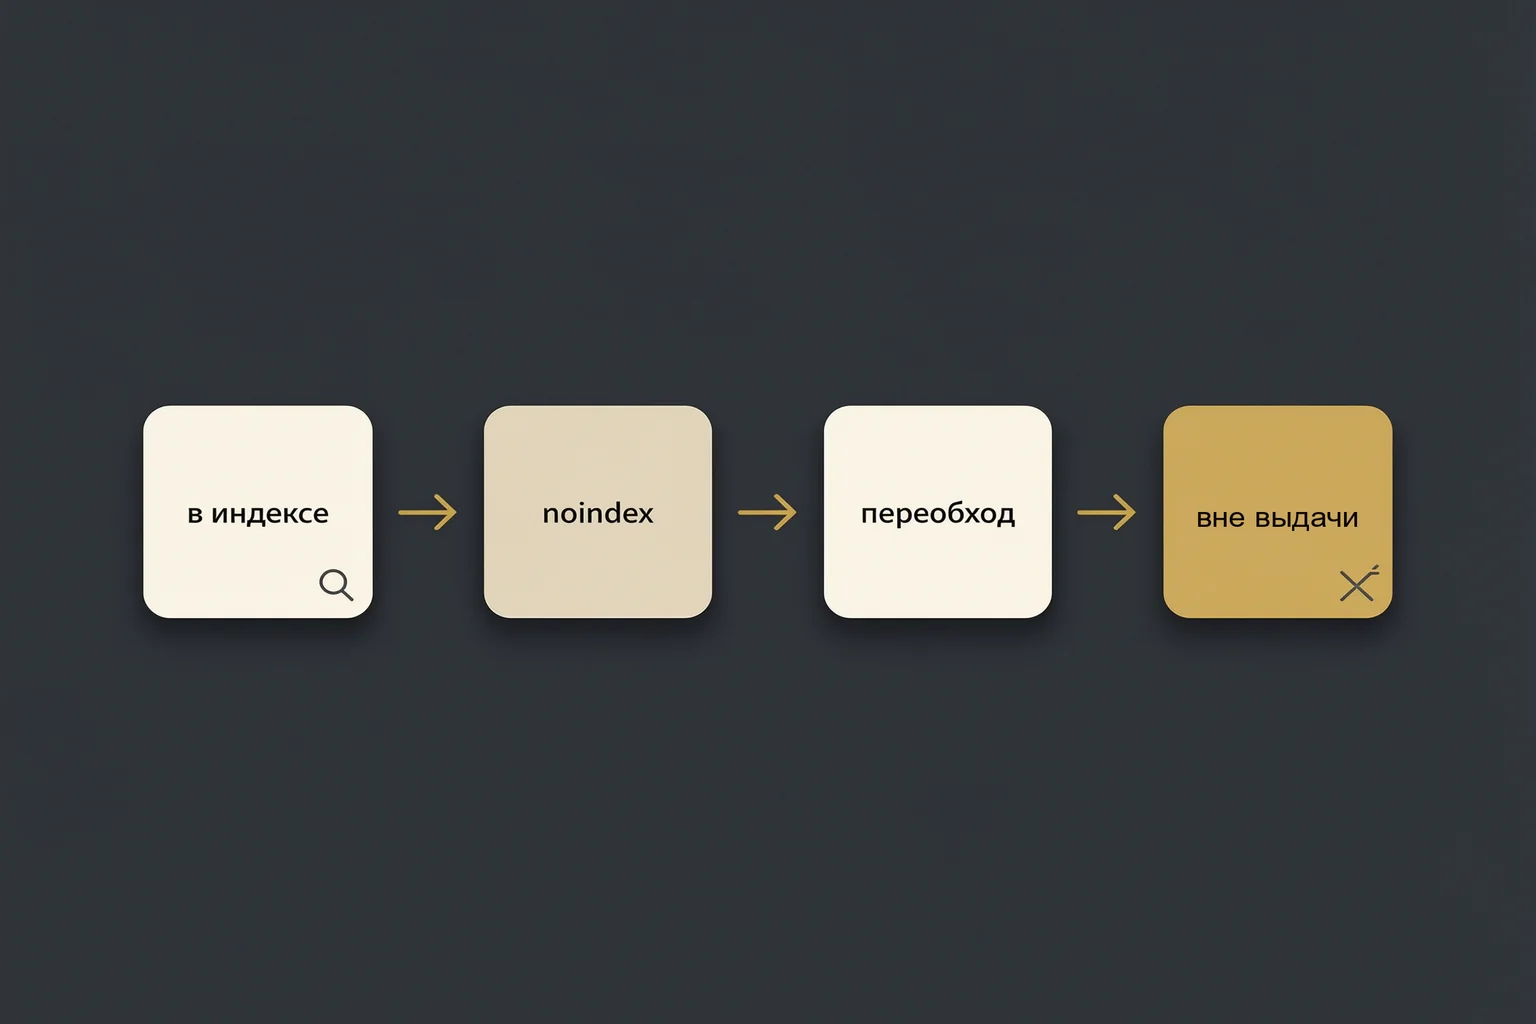
Проверка результата: оператор site:, инструмент проверки URL в GSC (блок «Индексирование Google» покажет, что страница исключена), раздел «Исключенные страницы» в Вебмастере.
Что умеет каждый инструмент: сводная таблица
| Инструмент | Что делает | Блокирует обход | Убирает из выдачи | Для файлов |
|---|---|---|---|---|
noindex (meta/X-Robots-Tag) | исключает страницу из поиска | нет | да | да, через заголовок |
robots.txt Disallow | запрещает скачивать URL | да | нет (адрес может висеть) | да |
404 / 410 | страница не существует | нет | да, со временем | да |
301 редирект | переносит адрес | нет | да, со временем | да |
| canonical | указывает главную версию дубля | нет | косвенно | да |
Когда возвращать 404 и 410
404 Not Found — страница больше не нужна по старому адресу: удаленная услуга, карточка без замены, завершенная акция. Если страницы нет, честный 404 лучше пустого шаблона «ничего не найдено», отдающего 200 OK: поисковик видит в этом soft 404 (страницу-пустышку), а посетитель — тупик.
410 Gone — усиленный сигнал: удалено окончательно, возврата не будет. Уместен для тестовых URL вроде /test/ или /promo-2023/, случайно попавших в индекс, старых служебных страниц и черновиков, затесавшихся в sitemap. Для большинства проектов разница невелика, но 410 уместен, когда возврата точно не будет.
И не забудьте UX: страница 404 — это не тупик, а развилка. Кастомный экран с навигацией и поиском возвращает часть живых посетителей.
Как закрыть тестовый сайт или админку
Отдельная боль — стейджинг и служебные разделы. Robots.txt для этого плох по двум причинам: файл публичен (Disallow на /admin/ фактически афиширует путь), а закрытие обхода не гарантирует выпадения из индекса.
Рабочие способы: HTTP-авторизация (basic auth) на тестовом домене, ограничение по IP на уровне сервера или закрытие всего домена паролем на хостинге. Тестовая версия, закрытая авторизацией, в индекс не попадает вообще.
Когда не нужен ни один из этих способов
Иногда страницу не нужно закрывать вовсе. Ее нужно:
- склеить через canonical;
- перевести на новый адрес через 301;
- переписать и усилить;
- встроить в нормальную структуру сайта.
Использовать noindex вместо архитектуры — значит временно маскировать проблему.
На одном проекте каталог разросся до нескольких тысяч URL с параметрами: часть закрыли в robots.txt, часть через noindex, часть оставили как есть. Через месяц в индексе сохранялся шум, а живые посадочные иногда теряли обход. После разметки случаев все упростилось: технические параметры — в robots.txt, слабые живые страницы — в noindex, умершие URL — в 410. Индекс начал очищаться предсказуемо и за шесть-восемь недель пришел к рабочему объему.
Частые вопросы
Чем Disallow в robots.txt отличается от noindex?
Disallow запрещает роботу скачивать страницу (экономит обход), но не убирает URL из поиска. Noindex убирает страницу из выдачи, но робот должен иметь возможность ее скачать. Частая ошибка — ставить оба сразу: робот не видит noindex за Disallow.
Как быстро страница вылетает из индекса после noindex?
Обычно от нескольких дней до нескольких недель. Ускоряется запросом переобхода в Вебмастере или Search Console. Дольше всего выпадают адреса с внешними ссылками.
Страница висит в выдаче без сниппета — что это значит?
Чаще всего URL закрыт в robots.txt: робот не может скачать страницу и показать описание, но адрес остается в базе, потому что известен по ссылкам. Чтобы убрать его полностью, снимите Disallow и поставьте noindex.
Можно ли ставить noindex и canonical одновременно?
Не рекомендуется: canonical — это «считай главной другую версию», noindex — «не показывай эту». Вместе сигналы противоречат друг другу. Для дублей с живой основной версией нужен canonical, для мусорных URL — noindex.
Яндекс понимает X-Robots-Tag?
Да, и meta robots, и X-Robots-Tag для файлов. Не существует отдельной директивы noindex в robots.txt — ни в Яндексе, ни в Google.
Чек-лист
- Для каждой закрываемой страницы понятен случай: скрыть из выдачи, сэкономить обход или удалить.
- Disallow снят с URL, на который ставится noindex.
- Для HTML используется meta robots, для файлов — X-Robots-Tag.
- robots.txt не используется как способ удаления из поиска.
- Удаленные страницы отдают честный
404или410, страница 404 с навигацией. - Тестовые стенды закрыты авторизацией, а не robots.txt.
- Проверка результата:
site:, Вебмастер, Search Console — через пару недель.
Итог
Закрытие страниц — не одна настройка, а разбор случаев: noindex прячет из выдачи живую страницу, robots.txt экономит обход, 404/410 фиксируют удаление, 301 и canonical решают судьбу дублей и переездов. Разложите URL по случаям один раз: индекс станет чище, а потери живых страниц прекратятся.
Понравился материал? Следующим шагом проверьте, нет ли у сайта конфликтов между удалением, каноникалами и редиректами.
Также рекомендуем:
- 301 и 302 редиректы: когда какой использовать
- Canonical URL: как выбрать главную версию страницы
- Robots.txt и sitemap.xml: как настроить файлы для обхода
- Индексация сайта в Яндексе и Google в 2026 году
Если индекс раздувается, а в поиске всплывают технические URL, проблема обычно не в одном теге, а в отсутствии внятной матрицы для всех типов страниц. Команда SEO Владимир поможет разложить URL по случаям, вычистить мусор и не потерять живые посадочные. Матрицу «что закрывать, а что оставлять» составляем в рамках технического аудита.
Тема статьи
Техническое SEO
Статьи про техническую сторону SEO: индексация и robots.txt, sitemap.xml, canonical и дубли, редиректы, Core Web Vitals и скорость, микроразметка, SPA и рендеринг. Вопросы, которые решаются в коде и настройках.
Читайте также
Похожие статьи
SEO URL (ЧПУ): что это такое и как настроить правильно
SEO URL (ЧПУ) простыми словами: структура адреса, длина до 60-80 знаков, транслит, кириллица или латиница, настройка в CMS и 301-редиректы при смене URL без потери позиций.
9 мин301 и 302 редиректы: когда какой использовать в SEO
301 и 302 редиректы: чем отличаются, как их видят Яндекс и Google, как настроить в htaccess и nginx, как проверить цепочки и не потерять позиции при переезде.
12 минКак выбрать разработчика сайта — 12 вопросов перед договором
Пошаговый чек-лист выбора подрядчика для создания сайта. От бюджета и ТЗ до исходников и гарантий — 12 вопросов, которые уберегут вас от перекупов и потерянного бюджета.
18 мин